第一部分:RabbitMQ理论基础
核心目标:理解RabbitMQ的本质、设计理念和核心组件,搞懂“消息如何流转”“为什么能保证可靠传输”,为后续实践和问题排查打下基础,避免只会用不会排错的困境。
1.1 什么是RabbitMQ?定位与优势
1.1.1 定义
RabbitMQ是一款基于AMQP协议(高级消息队列协议)开发的开源消息中间件,核心作用是实现系统间的异步通信、解耦、削峰填谷,避免系统直接调用导致的耦合过高、峰值压力击穿服务。
补充:AMQP协议是一种标准化的消息传递协议,定义了消息的结构、传输规则和组件交互方式,确保不同语言(Java、Python、Go等)、不同系统之间能通过RabbitMQ无缝通信。
1.1.2 核心优势(对比其他MQ:Kafka、RocketMQ)
| 优势 | 具体说明 | 适用场景 |
|---|---|---|
| 可靠性高 | 支持消息持久化、生产者确认、消费者确认、死信队列等机制,可最大限度避免消息丢失 | 订单通知、支付回调、核心业务消息传输(不允许丢失) |
| 灵活性强 | 支持多种交换机类型(Direct、Topic、Fanout、Headers),可灵活实现路由策略;支持队列绑定、过滤、延迟等高级特性 | 复杂路由场景(如多服务订阅同一类消息的不同分支)、广播通知 |
| 易用性好 | 提供可视化管理界面,部署简单,支持多种客户端语言,与Spring Boot等框架无缝集成 | 快速开发、中小规模系统、多语言协同开发 |
| 可扩展性强 | 支持集群部署,可用仲裁队列(quorum queue)为队列建立副本,通过增加节点提升并发处理能力和可用性 | 高并发、高可用场景(如电商大促) |
注意:RabbitMQ的短板是吞吐量低于Kafka,不适合海量日志、埋点等高频写入场景,此类场景优先选择Kafka;核心业务的异步通信、可靠传输场景,RabbitMQ是首选。
1.2 核心架构与组件
RabbitMQ的核心架构遵循“生产者-交换机-队列-消费者”的流转模型,每个组件各司其职,配合AMQP协议完成消息的传递,核心组件如下(按消息流转顺序):
1.2.1 核心组件详解
-
生产者(Producer):消息的发送方,负责将业务数据封装成消息,通过RabbitMQ客户端发送到交换机(Exchange)。
示例:Java系统中,订单创建成功后,生产者发送“订单创建消息”到RabbitMQ。 -
交换机(Exchange):消息的“路由中转站”,接收生产者发送的消息,根据预设的路由键(Routing Key)和绑定规则(Binding),将消息路由到对应的队列(Queue)。
核心特点:交换机不存储消息,仅负责路由;若没有匹配的队列,消息会被丢弃(除非开启“返回机制”)。 -
绑定(Binding):连接交换机(Exchange)和队列(Queue)的“桥梁”,同时指定绑定键(Binding Key),用于匹配生产者发送的路由键(Routing Key),决定消息是否能路由到该队列。
-
队列(Queue):消息的“存储容器”,接收交换机路由过来的消息,按顺序存储,等待消费者消费。
核心特点:队列是消息的最终存储载体,支持持久化(避免重启丢失)、限流(避免消费者被压垮)、优先级(高优先级消息优先消费)等特性。 -
消费者(Consumer):消息的接收方,通过RabbitMQ客户端监听队列,获取队列中的消息并处理业务逻辑。
示例:Java系统中,消费者监听“订单创建消息”,接收消息后执行“发送短信通知”“更新库存”等操作。 -
Broker:RabbitMQ的服务端实例,本质是一个进程,负责接收生产者消息、管理交换机和队列、转发消息给消费者,是整个RabbitMQ的核心运行载体。
补充:集群部署时,多个Broker节点协同工作,实现高可用和负载均衡。
1.2.2 消息流转流程
- 生产者通过客户端连接RabbitMQ Broker,创建连接(Connection)和信道(Channel);
- 生产者设置消息的路由键(Routing Key),将消息发送到指定的交换机(Exchange);
- 交换机根据绑定规则(Binding Key与Routing Key匹配),将消息路由到一个或多个对应的队列(Queue);
- 队列将消息持久化(若开启),按FIFO顺序存储消息;
- 消费者通过信道监听队列,获取消息并处理;
- 消费者处理完成后,向Broker发送确认信号(Ack),Broker收到后删除队列中的该条消息。
1.3 概念补充
1.3.1 信道(Channel)
定义:共享一个TCP连接的“轻量级连接”,是RabbitMQ客户端与Broker通信的核心载体。
为什么需要信道?
TCP连接的创建和销毁开销较大,若每个生产者/消费者都创建一个TCP连接,会导致Broker压力过大;信道基于TCP连接复用,一个TCP连接可包含多个信道,大幅降低连接开销,提升通信效率。
实战注意:Java开发中,每次发送/接收消息,都需通过信道操作,不可直接使用TCP连接。
1.3.2 虚拟主机(Virtual Host,vhost)
定义:RabbitMQ的“命名空间”,用于实现多租户隔离,每个vhost包含独立的交换机、队列、绑定规则和用户权限,不同vhost之间的组件相互独立,互不干扰。
实战场景:一个RabbitMQ Broker可部署多个项目,每个项目使用独立的vhost,避免不同项目的队列、交换机命名冲突,同时保障权限隔离(如A项目用户无法访问B项目的队列)。
默认vhost:“/”(斜杠),是RabbitMQ启动后默认创建的虚拟主机,可直接使用,也可根据需求自定义。
1.3.3 消息(Message)
结构:RabbitMQ中的消息由“消息头(Headers)”和“消息体(Body)”两部分组成:
- 消息头:存储消息的元数据,如路由键(Routing Key)、持久化标识(Delivery Mode)、过期时间(TTL)、消息ID等,Broker通过消息头判断消息的处理规则;
- 消息体:存储实际的业务数据(如JSON字符串、Java对象序列化后的字节数组),Broker不解析消息体,仅负责传递。
1.4 交换机类型
RabbitMQ支持4种核心交换机类型,不同类型的路由规则不同,需根据业务场景选择,其中Direct、Topic、Fanout是生产环境中最常用的3种。
| 交换机类型 | 路由规则 | 适用场景 | 示例说明 |
|---|---|---|---|
| Direct(直连交换机) | 路由键(Routing Key)与绑定键(Binding Key)完全匹配,消息才会路由到对应队列;一个路由键仅匹配一个队列(默认) | 点对点通信、精准路由(如订单ID对应的消息,仅被一个消费者处理) | 生产者发送路由键为“order.create”的消息,仅绑定键为“order.create”的队列能接收 |
| Topic(主题交换机) | 路由键与绑定键支持通配符匹配(*匹配一个单词,#匹配多个单词,单词之间用“.”分隔),灵活性最高 | 多服务订阅、模糊路由(如所有与“order”相关的消息,被多个消费者分别处理) | 绑定键为“order.#”的队列,可接收路由键为“order.create”“order.pay”“order.cancel”的所有消息 |
| Fanout(扇出交换机) | 不依赖路由键和绑定键,广播消息,将消息路由到所有与该交换机绑定的队列,忽略路由规则 | 广播通知、多服务同步数据(如系统启动通知、配置更新通知) | 交换机绑定3个队列,生产者发送消息后,3个队列都会收到该消息,与路由键无关 |
| Headers(头交换机) | 不使用路由键,通过**消息头(Headers)**的键值对匹配绑定规则,匹配成功则路由到对应队列 | 特殊场景(如消息头包含多组键值对,需精准匹配),极少使用 | 绑定队列时指定“type=email”,仅消息头包含“type=email”的消息能被路由 |
1.4.1 扇出的语义
四类交换机中只有Fanout(扇形交换机)不参与路由键匹配,它的行为可以用“扇出”概括:一份输入被原样复制成多份,分发给多个下游。
        [ 生产者的一条消息 ]
                 |
        [ Fanout 交换机 ](一个输入端点)
                 |
     ┌───────────┼───────────┐
     ↓           ↓           ↓
  [队列A]     [队列B]     [队列C](多个输出端点)
- 交换机收到消息后,绑定几个队列就复制几份,每个队列收到内容完全相同的一份消息。
- 各队列的消费互不影响:一个队列的消费者处理慢或出现异常,不改变其他队列收到的消息。
- 路由键在Fanout交换机上不产生区分效果,代码中传入的路由键取值对投递结果没有影响。
- 新绑定的队列从绑定时刻起开始接收该交换机上的全量消息,即广播会成倍放大下游负载。
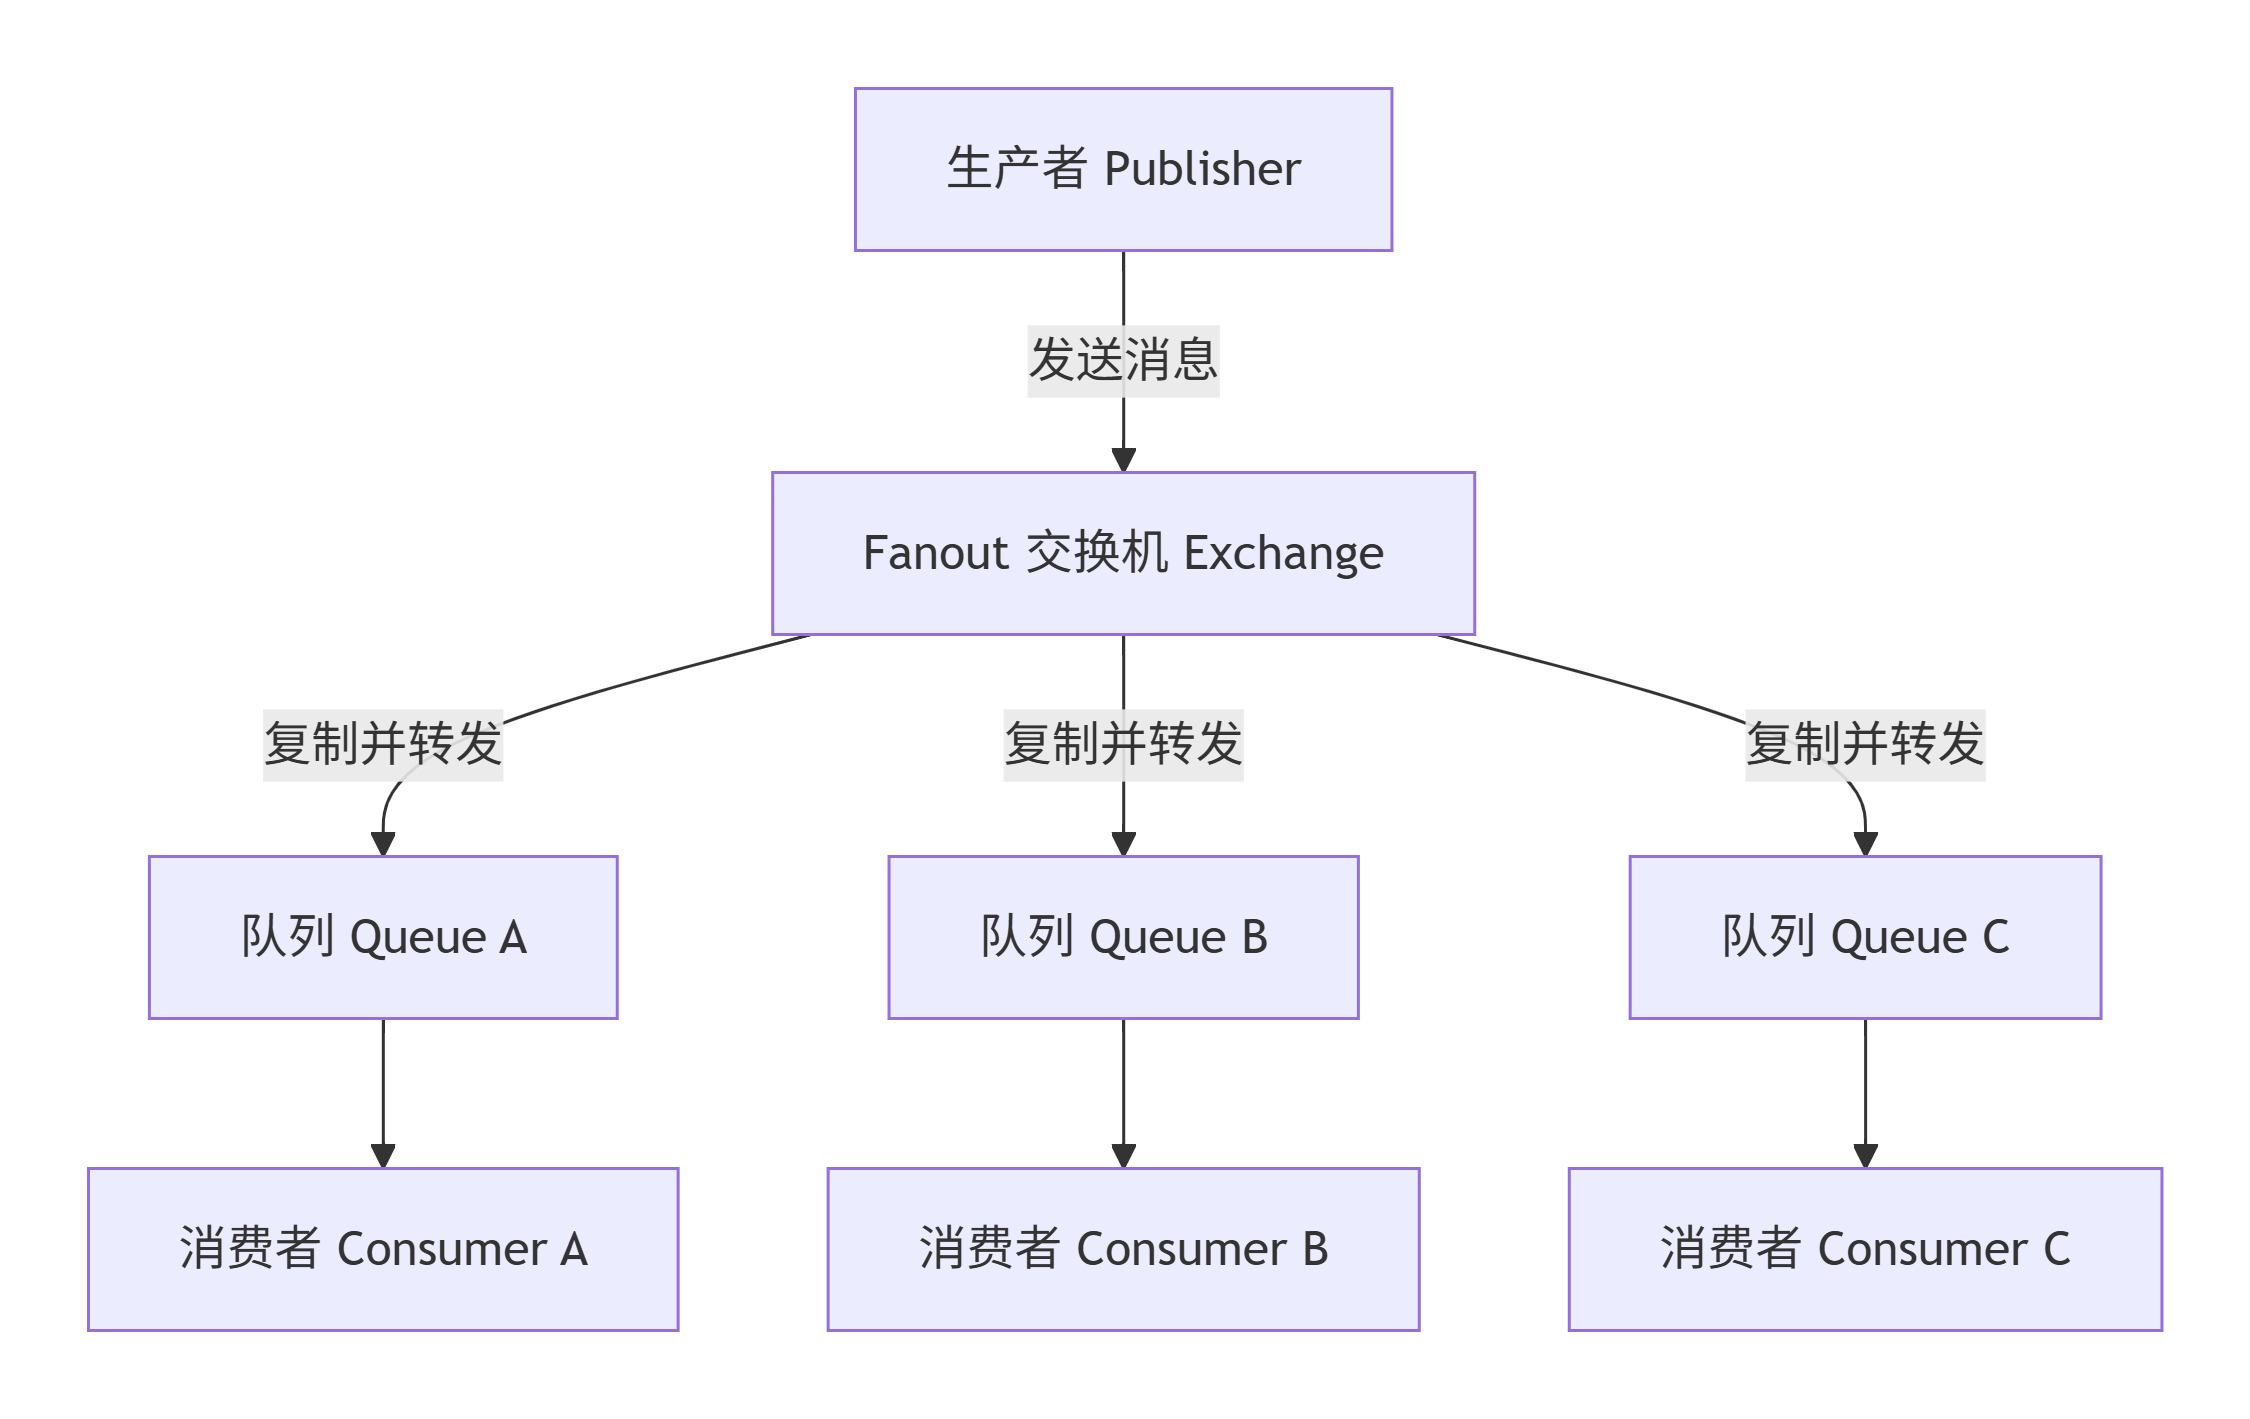
1.4.2 Fanout、Direct与Topic的差异
| 维度 | Direct | Topic | Fanout |
|---|---|---|---|
| 路由依据 | 路由键与绑定键完全相等 | 路由键与绑定键按通配符匹配 | 不参与匹配,忽略路由键 |
| 匹配粒度 | 单个完整路由键 | 以点分隔的多个层级 | 无 |
| 投递份数 | 匹配的队列(默认一个路由键对应一个队列) | 所有命中通配符的队列 | 绑定该交换机的全部队列 |
| 新增队列的接入方式 | 使用相同绑定键即可接收 | 绑定键落在通配符覆盖范围内即可接收 | 只要绑定该交换机即接收全量消息 |
| 生产者侧约束 | 路由键需与绑定键约定一致 | 路由键需符合层级约定 | 路由键与业务无关,传值不影响结果 |
| 典型适用场景 | 精准点对点、任务分发 | 微服务事件总线、日志分类订阅 | 广播通知、多下游同步 |
1.4.3 适用场景与注意事项
适合使用Fanout的场景:
- 全局通知:用户下单成功后,积分系统、物流系统、通知系统需要各自接收同一条订单事件,用Fanout交换机广播该消息,新增下游只需新增队列并绑定,生产者代码无需改动。
- 日志分发:应用日志发送到Fanout交换机,同时分发给实时监控面板、日志存储服务、错误报警系统三类下游。
注意事项:
- 广播意味着下游数量与消息复制份数正相关,队列数量增加会同步增加磁盘占用与投递开销。
- Fanout不提供选择性接收,只关心部分事件的队列不应绑定Fanout交换机,应改用Topic或Direct。
- 广播消息进入新的下游前应确认其消费能力,避免新绑定的队列被全量消息压垮。
第二部分:RabbitMQ核心机制
目标:掌握RabbitMQ的核心机制(持久化、确认、死信、延迟等),理解其底层实现逻辑,能够解决“消息丢失”“消息重复消费”“消息积压”等生产环境高频问题。
2.1 消息持久化机制
避免消息丢失,必开
定义:将消息、交换机、队列的元数据存储到磁盘,而非仅存于内存,确保RabbitMQ Broker重启后,消息不丢失。
注意:持久化机制会牺牲少量性能(磁盘I/O开销),但核心业务场景必须开启,非核心场景可根据需求关闭。
2.1.1 持久化的三个核心对象
-
队列持久化:创建队列时,设置“durable=true”,队列的元数据(名称、绑定规则、限流设置等)会被持久化到磁盘;若不设置,Broker重启后队列会消失,队列中的消息也会丢失。
-
交换机持久化:创建交换机时,设置“durable=true”,交换机的元数据会被持久化到磁盘;若不设置,Broker重启后交换机会消失,生产者发送消息时会报错(找不到交换机)。
-
消息持久化:发送消息时,设置消息头的“deliveryMode=2”(1为非持久化,2为持久化),消息体和消息头会被持久化到磁盘;若不设置,队列即使持久化,消息也会因Broker重启而丢失。
2.1.2 持久化流程与注意事项
持久化流程:消息发送到交换机→路由到队列→队列将消息写入磁盘(先写入临时文件,再同步到持久化文件)→Broker确认消息持久化完成。
注意事项:
-
仅开启队列/交换机持久化,不开启消息持久化,Broker重启后消息会丢失;
-
消息持久化是“异步写入”(默认),Broker重启时,可能会丢失少量未完成写入磁盘的消息(可通过“生产者确认机制”弥补);
-
非核心消息(如日志、通知)可关闭持久化,提升吞吐量。
2.2 消息确认机制
可靠传输的核心
核心目标:确保消息从“生产者→Broker→消费者”的全链路可靠传输,避免消息丢失,分为“生产者确认机制”和“消费者确认机制”两部分,需配合使用。
2.2.1 生产者确认机制(Publisher Confirm)
核心定义:生产者发送消息后,Broker会向生产者返回一个“确认信号”(ACK/NACK),告知生产者消息是否成功被Broker接收并持久化,若失败,生产者可重试发送,避免消息丢失。
两种确认模式(生产环境首选异步确认)
-
同步确认:生产者发送一条消息后,阻塞等待Broker返回确认信号,收到ACK后再发送下一条消息。
优点:简单易懂,确保消息顺序;缺点:阻塞导致吞吐量极低,不适合高并发场景。 -
异步确认:生产者发送消息后,不阻塞,继续发送下一条消息;Broker接收消息后,通过回调函数向生产者返回确认信号(ACK/NACK)。
优点:不阻塞,吞吐量高,适合高并发场景;缺点:实现稍复杂,需处理回调逻辑,需注意消息顺序(可通过消息ID关联)。
实战注意
- 开启生产者确认机制后,需在生产者客户端配置“publisher-confirm-type=correlated”(Spring Boot场景),确保回调函数能关联消息ID;
- 收到ACK:消息已成功被Broker接收并持久化,无需处理;
- 收到NACK:消息未被Broker接收(如交换机不存在、队列未绑定),需重试发送(建议设置重试次数上限,避免死循环);
- 超时未收到确认:可能是网络异常,需重试发送。
2.2.2 消费者确认机制(Consumer ACK)
核心定义:消费者接收消息后,根据消息处理结果,向Broker发送“确认信号”(ACK/NACK/Reject),Broker根据确认信号决定是否删除队列中的消息,避免消息重复消费或丢失。
三种确认类型
-
自动确认(autoAck=true):消费者接收消息后,Broker立即认为消息已处理完成,自动删除队列中的消息,无需消费者手动发送ACK。
优点:简单,吞吐量高;缺点:不可靠,若消费者处理消息时崩溃,消息会丢失(已被Broker删除),生产环境严禁使用。 -
手动确认(autoAck=false):消费者接收消息后,处理完成并确认无异常,手动向Broker发送ACK信号,Broker收到后删除消息;若处理失败,发送NACK/Reject信号,Broker根据配置决定是否重新投递消息。
优点:可靠,避免消息丢失和重复消费;缺点:需手动处理ACK逻辑,生产环境首选。 -
拒绝确认(Reject/NACK):
-
Reject:拒绝一条消息,参数“requeue=true”表示将消息重新放回队列,等待其他消费者处理;“requeue=false”表示直接丢弃消息(若开启死信队列,消息会被路由到死信队列);
-
NACK:拒绝多条消息(批量确认场景),参数与Reject一致,可批量处理失败消息。
-
实战注意
- 手动确认场景下,需确保“消息处理完成后再发送ACK”,避免提前发送ACK(处理失败时消息已被删除);
- 若消费者处理消息超时,Broker会认为消费者异常,将消息重新放回队列,可能导致消息重复消费(需配合“幂等性处理”);
- 建议设置“消费者超时时间”,避免消费者挂起导致消息一直未确认。
2.3 消息幂等性
解决重复消费
定义:无论消息被消费多少次,最终的业务结果都一致,不会因重复消费导致业务异常(如重复下单、重复扣款)。
为什么会出现重复消费?
- 消费者处理完成后,发送ACK时网络异常,Broker未收到,将消息重新放回队列,消费者再次接收;
- 生产者重试发送消息(如未收到Broker的ACK),导致Broker接收多条相同消息;
- 集群部署时,队列副本同步或leader选举异常,导致消息重复投递;
生产环境常用幂等性实现方案(按优先级排序)
-
基于消息ID实现(首选):
-
生产者发送消息时,在消息头中设置唯一的消息ID(如UUID、雪花ID);
-
消费者接收消息后,先查询Redis/MongoDB等缓存,判断该消息ID是否已被消费;
-
若未消费:处理业务逻辑,处理完成后将消息ID存入缓存(设置过期时间,避免缓存膨胀),再发送ACK;
-
若已消费:直接发送ACK,不处理业务逻辑。
-
-
基于业务唯一标识实现:
-
利用业务本身的唯一标识(如订单ID、支付流水号),代替消息ID;
-
消费者处理消息时,先查询数据库(如订单表),判断该业务标识是否已处理;
-
示例:处理“订单支付消息”时,先查询订单表,若订单已处于“支付成功”状态,直接ACK;若未支付,处理支付逻辑后更新订单状态,再ACK。
-
-
基于数据库唯一约束实现:
-
在数据库表中,对业务唯一标识设置唯一约束(如订单ID唯一);
-
消费者处理消息时,尝试向数据库插入数据,若插入成功(未重复),处理业务逻辑;若插入失败(唯一约束冲突),说明已消费,直接ACK。
-
2.4 死信队列(DLX)
处理异常消息,必配
定义:死信队列(Dead-Letter-Exchange,DLX)是一种特殊的队列,用于存储“无法被正常消费”的消息(死信),避免死信占用正常队列资源,同时便于后续排查异常原因、重试处理。
2.4.1 死信产生的3种场景
-
消息过期(TTL过期):消息设置了过期时间,超过时间未被消费,成为死信;
-
队列满了:队列设置了最大长度(限流),消息达到最大长度后,新消息无法入队,成为死信;
-
消息被拒绝:消费者拒绝消费消息(Reject/NACK),且设置“requeue=false”,消息成为死信。
2.4.2 死信队列的配置流程
-
创建死信交换机(DLX Exchange):类型建议为Direct或Topic,需开启持久化;
-
创建死信队列(DLX Queue):需开启持久化,绑定到死信交换机,设置绑定键;
-
创建正常队列:在正常队列的参数中,设置“x-dead-letter-exchange”(死信交换机名称)和“x-dead-letter-routing-key”(死信路由键,与死信队列的绑定键匹配);
-
正常队列绑定到正常交换机,生产者发送消息到正常交换机;
-
消息成为死信后,Broker会自动将其路由到死信交换机,再转发到死信队列,等待后续处理。
2.4.3 死信的后续处理方案
-
人工排查:监听死信队列,定期查看死信消息,分析异常原因(如消息格式错误、业务逻辑异常),修复后手动重试发送;
-
自动重试:创建重试消费者,监听死信队列,设置重试次数(如3次),每次重试间隔一定时间(如5秒),重试失败后,可存入数据库归档;
-
归档删除:对于无法修复的死信,定期归档到数据库,然后删除死信队列中的消息,避免占用资源。
2.5 消息延迟机制(延迟队列)
核心定义:延迟队列用于实现“消息延迟一段时间后再被消费”,如订单创建后30分钟未支付,自动取消;定时任务(如每天凌晨2点执行数据统计)。
注意:RabbitMQ本身不直接支持延迟队列,但可通过“TTL消息+死信队列”间接实现,也可安装“rabbitmq-delayed-message-exchange”插件,实现更灵活的延迟功能。
2.5.1 方案1:TTL消息+死信队列(无插件)
核心原理:利用“消息过期后成为死信,被路由到死信队列”的特性,让死信队列成为延迟队列,消费者监听死信队列,实现延迟消费。
-
配置死信交换机和死信队列(同2.4.2);
-
创建“延迟队列”(本质是正常队列,仅用于存储延迟消息),设置死信交换机和死信路由键;
-
该延迟队列不绑定任何消费者(确保消息在队列中过期);
-
生产者发送消息时,设置消息的TTL(过期时间,如30分钟),发送到延迟队列;
-
消息在延迟队列中等待TTL过期,成为死信,被自动路由到死信队列;
-
消费者监听死信队列,接收消息并处理(此时消息已延迟指定时间)。
2.5.2 方案2:安装延迟交换机插件
灵活,推荐高并发场景
原理:安装“rabbitmq-delayed-message-exchange”插件后,可创建“延迟交换机”(x-delayed-message类型),消息发送到该交换机后,会根据设置的延迟时间,延迟指定时间后再路由到目标队列,无需依赖死信队列。
-
安装插件(Linux场景):
rabbitmq-plugins enable rabbitmq_delayed_message_exchange,重启RabbitMQ; -
创建延迟交换机:类型选择“x-delayed-message”,开启持久化,设置“x-delayed-type”(底层路由类型,如direct、topic);
-
创建目标队列(延迟消费的队列),绑定到延迟交换机,设置绑定键;
-
生产者发送消息时,在消息头中设置“x-delay”(延迟时间,单位:毫秒),发送到延迟交换机;
-
交换机延迟指定时间后,将消息路由到目标队列,消费者监听目标队列,实现延迟消费。
2.5.3 两种方案对比
| 方案 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|
| TTL+死信队列 | 无需安装插件,配置简单,兼容性好 | 延迟时间固定(队列级TTL),灵活度低;消息堆积时,延迟时间不准确 | 延迟时间固定、低并发场景(如订单30分钟取消) |
| 延迟交换机插件 | 延迟时间灵活(每条消息可设置不同延迟);延迟准确,支持高并发 | 需安装插件;插件升级可能存在兼容性问题 | 延迟时间不固定、高并发场景(如不同订单延迟不同时间取消) |
2.6 队列限流与流量控制
避免消费者被压垮,必配
定义:队列限流是指限制消费者每次从队列中获取的消息数量,避免大量消息同时涌入消费者,导致消费者线程阻塞、内存溢出,实现流量控制,保护消费者服务。
2.6.1 配置
手动确认模式下生效
在消费者客户端配置“prefetchCount”(预取数量),表示消费者每次从队列中预取的消息数量,只有当消费者确认了这些消息(发送ACK),才会继续预取下一批消息。
-
prefetchCount=1:消费者每次只获取1条消息,处理完成并确认后,再获取下一条,适合单线程处理,确保消息顺序;
-
prefetchCount=N(N>1):消费者每次获取N条消息,批量处理,提升吞吐量,适合多线程处理场景;
-
注意:限流仅在“手动确认模式(autoAck=false)”下生效,自动确认模式下无效。
2.6.2 实战建议
-
单线程消费者:prefetchCount=1,确保消息顺序,避免并发处理导致的业务异常;
-
多线程消费者(如Spring Boot的@RabbitListener配置concurrency):prefetchCount=5~10,根据消费者处理能力调整,平衡吞吐量和稳定性;
-
高并发场景:结合队列最大长度(x-max-length),避免队列消息堆积过多,超出队列容量后,新消息成为死信(或被丢弃)。
第三部分:RabbitMQ实战部署(Linux环境)
核心目标:掌握RabbitMQ在Linux环境下的单机部署、集群部署与队列高可用(仲裁队列)、水位与连接参数、监控告警指标、元数据备份与恢复、网络分区处理,以及基础运维命令,满足生产环境的部署和维护需求。
前置依赖:RabbitMQ基于Erlang语言开发,部署前需先安装Erlang,且Erlang版本与RabbitMQ版本需兼容(参考RabbitMQ官方文档,3.12+版本推荐Erlang 25+)。
3.1 单机部署(基础)
3.1.1 步骤1:安装Erlang
# 1. 添加Erlang官方仓库
curl -fsSL https://packages.erlang-solutions.com/debian/erlang_solutions.asc | sudo gpg --dearmor -o /usr/share/keyrings/erlang-solutions-archive-keyring.gpg
echo "deb [signed-by=/usr/share/keyrings/erlang-solutions-archive-keyring.gpg] https://packages.erlang-solutions.com/debian $(lsb_release -cs) contrib" | sudo tee /etc/apt/sources.list.d/erlang-solutions.list

# 2. 更新仓库并安装Erlang(25版本)
sudo apt update
sudo apt install -y erlang=1:25.3.2.8-1

# 3. 验证Erlang安装
erl -version # 显示Erlang/OTP 25即可
3.1.2 步骤2:安装RabbitMQ
# 1. 添加RabbitMQ官方仓库
curl -fsSL https://github.com/rabbitmq/signing-keys/releases/download/2.0/rabbitmq-release-signing-key.asc | sudo gpg --dearmor -o /usr/share/keyrings/rabbitmq-archive-keyring.gpg
echo "deb [signed-by=/usr/share/keyrings/rabbitmq-archive-keyring.gpg] https://dl.cloudsmith.io/public/rabbitmq/rabbitmq-server/deb/debian $(lsb_release -cs) main" | sudo tee /etc/apt/sources.list.d/rabbitmq.list

# 2. 更新仓库并安装RabbitMQ(3.12版本)
sudo apt update
sudo apt install -y rabbitmq-server=3.12.12-1

# 3. 启动RabbitMQ服务
sudo systemctl start rabbitmq-server
sudo systemctl enable rabbitmq-server # 设置开机自启

# 4. 验证RabbitMQ状态
sudo systemctl status rabbitmq-server # 显示active (running)即可
3.1.3 步骤3:基础配置
- 启用管理界面(可视化管理,方便操作):
sudo rabbitmq-plugins enable rabbitmq_management
- 创建管理员用户(默认用户guest/guest,仅本地可访问,生产环境需创建自定义用户):
# 创建用户(用户名:admin,密码:123456,可自定义)
sudo rabbitmqctl add_user admin 123456
设置用户为管理员权限
sudo rabbitmqctl set_user_tags admin administrator
设置用户权限(允许访问所有vhost的所有资源)
sudo rabbitmqctl set_permissions -p "/" admin ".*" ".*" ".*"
删除默认guest用户
sudo rabbitmqctl delete_user guest
-
访问管理界面:
浏览器访问http://服务器IP:15672,使用创建的admin/123456登录,即可看到RabbitMQ的可视化管理界面(交换机、队列、用户等均可在此操作)。 -
开放端口(若开启防火墙,需开放以下端口):
`# 5672:RabbitMQ客户端通信端口(生产者/消费者连接端口)
15672:管理界面端口
25672:集群节点通信端口(单机部署可不开)
sudo ufw allow 5672
sudo ufw allow 15672
sudo ufw reload
3.2 集群部署与队列高可用
目标:通过多节点集群部署,避免单一节点故障导致RabbitMQ不可用;并让队列具备跨节点的消息副本,使部分节点故障时队列仍可读写。
集群架构:节点数量取奇数(3节点或5节点),节点之间通过Erlang Cookie实现通信(Cookie必须一致)。
集群与队列高可用解决的是两件事,需要分开理解:
- 集群解决的是元数据与路由:交换机、队列、绑定的定义在所有节点可见,客户端连接任意节点都能定位到目标交换机与队列。
- 队列高可用解决的是消息副本:默认的经典队列(classic queue)消息只存放在队列创建时所在的节点,该节点故障后该队列不可读写。因此仅完成集群组建并不构成队列高可用,还必须在声明队列时选择带副本的队列类型(仲裁队列),见3.2.4。
3.2.1 前置准备(3台Linux服务器)
-
3台服务器配置:IP分别为192.168.1.101(node1,主节点)、192.168.1.102(node2,从节点)、192.168.1.103(node3,从节点);
-
每台服务器均按3.1步骤,完成RabbitMQ单机部署(确保Erlang版本、RabbitMQ版本一致);
-
关闭每台服务器的防火墙(或开放相关端口),确保节点之间能相互通信;
-
配置主机名映射(每台服务器都需配置):
sudo vim /etc/hosts,添加以下内容:
192.168.1.101 node1
192.168.1.102 node2
192.168.1.103 node3
3.2.2 步骤1:同步Erlang Cookie
Erlang Cookie是RabbitMQ集群节点之间通信的“密钥”,所有节点的Cookie必须完全一致,否则无法加入集群。
# 1. 在node1(主节点)查看Cookie
sudo cat /var/lib/rabbitmq/.erlang.cookie

# 2. 在node2和node3上,覆盖Cookie(替换为node1的Cookie值)
sudo echo "node1的Cookie值" > /var/lib/rabbitmq/.erlang.cookie

# 3. 重启node2和node3的RabbitMQ服务
sudo systemctl restart rabbitmq-server
3.2.3 步骤2:组建集群
# 1. 在node2上,停止RabbitMQ应用,重置节点,加入集群(连接node1)
sudo rabbitmqctl stop_app
sudo rabbitmqctl reset
sudo rabbitmqctl join_cluster rabbit@node1
sudo rabbitmqctl start_app

# 2. 在node3上,执行相同操作,加入集群
sudo rabbitmqctl stop_app
sudo rabbitmqctl reset
sudo rabbitmqctl join_cluster rabbit@node1
sudo rabbitmqctl start_app

# 3. 在node1上,查看集群状态(确认3个节点均已加入)
sudo rabbitmqctl cluster_status
注意:本步骤完成的是集群组建,队列的消息内容仍只存放在声明该队列的节点上。队列的高可用需要在声明队列时选择带副本的队列类型,见3.2.4。
3.2.4 步骤3:声明仲裁队列(quorum queue)
仲裁队列(quorum queue)自RabbitMQ 3.8引入,是基于Raft共识算法的持久化、可复制FIFO队列,官方将其作为需要副本保障高可用时的默认选择。
声明方式
队列类型在声明时确定,通过在队列参数中指定 x-queue-type:
@Bean
public Queue orderQueue() {
    // 关键:通过 x-queue-type 参数声明为仲裁队列
    return QueueBuilder.durable("order_queue")
            .withArgument("x-queue-type", "quorum")
            .build();
}
也可以在vhost级别设置默认队列类型,让未显式指定类型的队列按仲裁队列创建:
# 创建vhost并指定默认队列类型(该能力随版本不同,以所用版本的文档为准)
rabbitmqctl add_vhost /order --default-queue-type quorum
注意:队列类型必须由客户端在声明队列时提供,不能用策略(policy)设置或变更。策略只能为已存在的仲裁队列调整运行参数(长度上限、溢出行为、过期时间、死信交换机、投递次数上限等),不能把已存在的经典队列变成仲裁队列。
声明要求与限制
| 项目 | 仲裁队列 | 经典队列 |
|---|---|---|
| 持久化 | 必须持久化(durable=true),不支持非持久化队列 | 可声明为非持久化 |
| 排他性 | 不支持排他队列(exclusive),不适合作为临时队列或RPC回调队列 | 支持 |
| 消息持久化 | 始终按持久化处理,与消息头deliveryMode取值无关 | 按deliveryMode逐条决定 |
| 消息优先级 | 不支持(无x-max-priority) | 支持 |
| 消费者优先级、单活跃消费者 | 支持 | 支持 |
| 通道级全局QoS(global prefetch) | 不支持,只支持每个消费者的prefetch | 支持 |
| 服务端命名队列 | 不支持 | 支持 |
| 队列长度上限 | 支持drop-head与reject-publish;不支持x-overflow=reject-publish-dlx,且reject-publish不严格,可能超出上限若干条 | 支持全部溢出策略 |
| 副本成员的变更 | 需要显式操作(手动) | 不涉及 |
补充说明:
- 不支持消息优先级时,需要按优先级拆分为多个队列,由不同的消费者分别处理。
- 仲裁队列不提供消息体常驻内存的惰性模式,消息体写入Raft日志,内存中只保留元数据;因此堆积场景下的磁盘占用高于经典队列,应设置长度上限避免无界堆积。
副本数与多数派
- 仲裁队列在集群中维护若干副本(组成员),其中一个为leader,其余为follower。生产者写入时由leader写入Raft日志并并行复制到follower,获得多数派确认后才向生产者返回确认。
- 多数派数量为
floor(N/2)+1:3副本容忍1个节点故障,5副本容忍2个节点故障。副本数受集群节点数约束,副本数超过节点数不产生额外冗余。 - 副本数默认3;可在声明队列时用队列参数
x-quorum-initial-group-size指定,运行期用rabbitmq-queues grow/shrink调整。 - leader在集群中的分布会影响节点负载,可用
rabbitmq-queues rebalance quorum把leader分散到不同节点。 - 生产者应开启发布确认(Publisher Confirms):仲裁队列的确认是在消息复制到多数派之后才返回;消费者应使用手动确认,使处理失败的消息回到队列。
策略示例
策略用于调整已存在的仲裁队列的运行参数:
# 为 /order 中所有以 order_ 开头的队列设置长度上限、溢出行为与投递次数上限
rabbitmqctl set_policy -p /order order-quorum "^order_" \
  '{"max-length":100000,"max-length-bytes":1073741824,"overflow":"reject-publish","delivery-limit":5}' \
  --apply-to queues

# 查看生效的策略
rabbitmqctl list_policies -p /order
- 仲裁队列支持的策略键包括 max-length、max-length-bytes、overflow、expires、dead-letter-exchange、dead-letter-routing-key、max-in-memory-length、max-in-memory-bytes、delivery-limit。
delivery-limit是仲裁队列特有的毒消息(poison message)保护:同一条消息被重投达到上限后不再重投,可按需转入死信队列,避免反复占用消费者。
适用与不适用
- 适用:队列长期存在、数据安全与故障容错优先于最低延迟的核心业务队列(如订单、支付、库存变更)。
- 不适用:临时队列与排他队列(RPC回调、短生命周期任务队列)、需要消息优先级、需要极低写入延迟、以吞吐为唯一目标的场景;这些场景使用经典队列。
3.2.5 步骤4:集群与队列高可用验证
- 通过管理界面访问任意节点(如http://192.168.1.101:15672),登录后在“Admin → Cluster”中查看3个节点的状态(running);
- 进入Queues页面,确认队列的Type为quorum,副本(Members)分布在多个节点,Leader列显示当前leader所在节点;
- 命令行核对:
# 查看队列类型、leader与副本成员
rabbitmqctl list_queues name type leader members online durable

# 将leader分散到不同节点(可选)
rabbitmq-queues rebalance quorum
- 停止leader所在节点(
sudo systemctl stop rabbitmq-server),观察该队列自动选举出新的leader,队列仍可读写,消息不丢失;节点重新启动后确认其作为follower重新加入并追平数据。
3.2.6 镜像队列的历史与弃用
镜像队列(classic mirrored queue)是早期为经典队列提供的集群复制能力,通过策略启用:
# 历史用法:把所有队列镜像到集群中的全部节点
sudo rabbitmqctl set_policy ha-all "^" '{"ha-mode":"all"}'
原有语义:
ha-mode=all:队列在集群每个节点上各保存一份副本;ha-mode=exactly配合ha-params:指定副本数量;ha-mode=nodes配合ha-params:指定副本所在节点;- 队列有一个master与若干mirror,写入采用链式复制:master需要等所有mirror保存消息后才向生产者返回确认。
不再推荐的原因:
- 官方在RabbitMQ 3.9中弃用经典镜像队列,并在4.0中移除了该功能;在3.9及之后的版本上使用镜像队列会收到弃用提示。
- 链式复制使一个慢副本拖慢整个队列,副本数增加时吞吐明显下降,效率低于仲裁队列的并行复制。
- 网络分区下的行为不易预期,存在过早在master上确认消息的场景,可能导致消息丢失;节点故障恢复后需要重建副本,重建期间队列阻塞。
- 副本所在节点数据丢失后,不具备仲裁队列那种基于多数派的恢复能力。
因此新部署不再使用镜像队列策略,队列高可用统一使用3.2.4的仲裁队列。若环境由早期版本升级而来,可用以下命令检出仍在生效的镜像队列策略:
# 集群中是否残留启用镜像队列的策略(存在时返回非零退出码)
rabbitmq-diagnostics check_if_cluster_has_classic_queue_mirroring_policy

# 列出具体是哪些策略启用了镜像队列
rabbitmq-diagnostics list_policies_with_classic_queue_mirroring --formatter=pretty_table
3.2.7 从镜像队列迁移到仲裁队列
前提认知:经典队列不能就地转换为仲裁队列。队列类型在声明时固定,两类队列的存储结构不同,迁移的实质是用新的仲裁队列承接同一业务,逐步转移流量与存量消息。
迁移步骤:
- 盘点:用3.2.6的命令列出仍被镜像策略覆盖的队列,逐个记录队列名、所属vhost、绑定关系、交换机与绑定键、消费者数量以及消息属性(TTL、优先级、长度上限、死信配置)。
- 差异评估:对照3.2.4的声明要求逐项确认兼容性——是否使用消息优先级、是否依赖排他队列或服务端命名队列、是否使用通道级全局QoS、是否使用
x-overflow=reject-publish-dlx、队列是否会出现大量堆积。存在不兼容用法时先调整代码或方案,再进入下一步。 - 建立新队列:以新名称声明仲裁队列(例如 order_queue 新建为 order_queue_qq),使用相同的交换机与绑定键完成绑定,死信交换机与死信路由键保持一致。
- 过渡(双写或双读择一):
- 双写:生产者在过渡期内向新旧两个队列各发送一份消息,消费者优先消费新队列;旧队列停止消费后按第5步处理存量。
- 双读:生产者继续写入旧队列,新增一个消费者同时消费新旧两个队列,新队列开始积累全量消息。
两种方式都要求消费端具备幂等能力,过渡期内同一业务消息会被处理两次。
- 消费完旧队列存量:保持旧队列有消费者运行,直到就绪消息数与未确认消息数均为0,并核对业务侧处理量与死信数量。
- 切换生产者:确认新队列的消息量、消费延迟与死信率与迁移前基线一致后,把生产者全部指向新队列,去除双写逻辑。
- 下线旧队列:观察一个完整业务周期,确认新队列流量正常、无遗留生产者后,删除旧队列与对应的镜像队列策略。
高危:删除旧队列会同时删除其中未消费的消息、绑定关系与消费位点,不可撤销。执行前确认旧队列就绪消息数与未确认消息数均为0、已无生产者写入、元数据已导出(见3.6),并与业务表核对消息数量。回滚方式:删除后无法恢复旧队列及其消息,只能按3.6的definitions备份重建空队列并由上游重发,因此删除前的核对是唯一的保障;建议在业务低峰执行,并把删除前的观察期作为回滚窗口,回滚即停止双写并把生产者切回旧队列。
验证清单:
- 队列类型与持久化:
rabbitmqctl list_queues name type durable中类型为quorum、durable为true; - 副本分布:副本成员覆盖多个节点,leader分散在不同节点;逐个停止副本所在节点,验证leader切换后队列仍可读写;
- 业务核对:生产量、消费量、死信量、消费延迟与迁移前基线比对,差异可解释;
- 监控覆盖:队列深度、未确认数、内存与磁盘水位、死信增量均已纳入告警(见3.5);
- 兼容项复查:确认不再使用通道级全局QoS、消息优先级等仲裁队列不支持的用法。
回滚方式:在删除旧队列之前迁移始终可回退——停止双写并把生产者切回旧队列即可,旧队列在过渡期内保持完整且可读写;执行第7步删除后失去回滚点。
3.2.8 classic、quorum、stream 三类队列的定位
| 队列类型 | 数据组织 | 复制与高可用 | 消费语义 | 主要适用场景 | 主要限制 |
|---|---|---|---|---|---|
| classic(经典队列) | 队列存储,消息被确认后删除 | 无副本(镜像能力已移除) | 竞争消费,单条消息只被一个消费者处理 | 临时队列、RPC回调队列、可容忍丢失的非核心消息 | 节点故障后队列不可读写,不提供复制 |
| quorum(仲裁队列) | Raft日志,按副本存储 | 基于多数派的副本,leader故障自动选举 | 竞争消费,支持毒消息处理与投递次数上限 | 长期存在、对数据安全与容错要求高的业务队列 | 不支持消息优先级、排他队列、非持久化与通道级全局QoS;写入延迟与磁盘占用高于classic |
| stream(流队列) | 追加写日志,按偏移量读取 | 基于Raft的副本 | 多个消费者各自维护偏移量,同一份数据可被重复读取 | 大量消费者读取同一份数据、需要回放历史消息(事件分发、审计、日志类数据) | 偏移量需要显式管理,不适用于单条消息级别的精细调度与逐条删除 |
差异要点:
- classic面向单条消息的投递与确认,适合短生命周期、可按需丢弃的消息;stream面向可重读的数据流,消息不因被读取而删除,删除由保留策略决定。
- stream适合“同一份消息被多组消费者各自读取”与“历史消息重放”,不依赖TTL、优先级与逐条确认删除;因此任务分发类场景仍应使用quorum或classic。
- 三类队列都遵循AMQP的交换机与绑定模型,差别在存储与复制方式,选择取决于对数据安全、延迟与可重读性的取舍;与产品无关的模型判据见 消息队列基础与模型 第2.1节与第2.4节。
3.3 内存与磁盘水位告警
目标:理解内存与磁盘两个水位参数的含义,掌握水位触发后的现象、被阻塞生产者的定位方式与参数调整的回滚方式。
3.3.1 两个水位参数
| 参数 | 含义 | 配置形式 | 默认值 |
|---|---|---|---|
| vm_memory_high_watermark | 节点内存使用量的上限,达到后阻塞生产者并开始换页 | 相对值(0~1的比例)或绝对值 | 相对值0.4 |
| disk_free_limit | 磁盘剩余空间的下限,低于该值后阻塞生产者 | 绝对值或相对总磁盘容量的比例 | 绝对值50MB |
# /etc/rabbitmq/rabbitmq.conf
# 内存水位:相对值,按节点识别到的可用内存计算
vm_memory_high_watermark.relative = 0.4
# 内存水位:绝对值,容器部署建议使用该形式,避免按宿主机内存计算
# vm_memory_high_watermark.absolute = 2GB

# 磁盘剩余下限:绝对值
disk_free_limit.absolute = 5GB
# 磁盘剩余下限:相对总磁盘容量的比例
# disk_free_limit.relative = 1.0

# 换页阈值:内存使用量达到水位的该比例时把消息体换出到磁盘
vm_memory_high_watermark_paging_ratio = 0.5
- 相对内存水位按节点识别到的内存计算。容器中若未正确识别内存限额,水位会按宿主机内存推算而偏高,容器部署建议使用绝对值。
- 磁盘剩余下限应留出处置时间:按磁盘增长速率估算,保证告警后有足够时间清理或扩容。
- 磁盘剩余下限过高会频繁触发阻塞,过低则处置窗口不足。
3.3.2 达到水位后的现象
- 内存水位触发:Broker 阻塞所有发布连接的写入(blocked connection),同时开始把队列中的消息体换出到磁盘(paging)。已建立的消费者与确认流程不受阻塞,正在进行的投递可以继续。
- 磁盘水位触发:同样阻塞生产者连接,消费者不受影响;此时磁盘已接近写满,继续写入会造成写入被拒绝甚至元数据损坏。
- 两类水位都由节点自行判定,触发与解除是自动的:水位回落到阈值以下后连接自动恢复,但期间生产端会表现为发送挂起或超时。
- 日志中出现资源告警记录,形如
memory resource limit alarm set、disk free limit alarm set,解除时出现对应的cleared记录。
3.3.3 定位被阻塞的生产者与根因
# 1. 查看处于blocked或blocking状态的连接(state列),定位到具体用户、vhost与来源
rabbitmqctl list_connections name user vhost peer_host state channels

# 2. 查看内存占用构成,定位来源(队列、连接、二进制、其他进程)
rabbitmq-diagnostics memory_breakdown

# 3. 查看处于paging状态的队列与堆积量
rabbitmqctl list_queues name state messages messages_ready messages_unacknowledged

# 4. 查看当前生效的内存水位与磁盘下限
rabbitmqctl status | grep -A5 -i watermark
管理界面的对应位置:Overview 页面显示内存与磁盘水位的状态与告警;Connections 页面可按 state 过滤出 blocked/blocking 的连接,并显示其所属用户与vhost。
常见根因:
- 消费停滞或消费能力不足导致队列堆积,消息占用内存与磁盘;
- 消费者prefetch取值过大,未确认消息在服务端占用大量内存;
- 消息体过大,同等条数下内存与磁盘消耗成倍增加;
- 队列数量或连接数量异常增长,元数据本身占用内存;
- 磁盘增长来自日志、副本重建或死信队列堆积,而非业务消息本身。
3.3.4 参数调整与回滚
运行时可以调整两个水位参数,验证效果后再固化到配置文件:
# 内存水位:调整为相对值0.4(按内存占比)
rabbitmqctl set_vm_memory_high_watermark 0.4

# 内存水位:调整为绝对值2GB
rabbitmqctl set_vm_memory_high_watermark absolute 2GB

# 磁盘剩余下限:调整为绝对值5GB
rabbitmqctl set_disk_free_limit 5GB

# 磁盘剩余下限:调整为内存大小的1倍
rabbitmqctl set_disk_free_limit mem_relative 1.0
高危:调高内存水位会压缩缓冲空间,节点可能因内存耗尽被OOM Killer终止并重启,重启期间队列副本需要重新选举与追平,未确认消息可能回退;调低磁盘剩余下限会缩短处置窗口,磁盘真正写满后写入被拒绝并存在元数据损坏风险,只能依赖副本或上游重发补齐消息。执行前先记录当前生效值(rabbitmqctl status 中的水位信息或原rabbitmq.conf),并核对节点的物理内存、容器内存限额与磁盘剩余量。回滚方式:用相同命令传回原值即可恢复(如 rabbitmqctl set_vm_memory_high_watermark 0.4),已建立的连接不受影响;修改后持续观察一个业务周期,重点核对告警是否早于阻塞触发、阻塞持续时间与业务影响,确认无副作用后再写入配置文件固化。
3.4 连接与通道限制
目标:掌握连接数与通道数的约束来源、连接暴涨的排查顺序,以及心跳与超时配置对连接稳定性的影响。
3.4.1 连接数的约束来源
| 层面 | 约束项 | 说明 |
|---|---|---|
| 操作系统 | 文件描述符上限(fs.file-max)与进程级上限(ulimit -n) | 每个连接占用一个文件描述符与一个Erlang进程,连接数上限最终受文件描述符限制 |
| RabbitMQ配置 | connection_max | 单节点允许的最大连接数,默认不限制,按需设置 |
| vhost限制 | max-connections | 单个vhost允许的最大连接数,用于多租户隔离,防止单个租户占用共享资源 |
| 客户端 | 连接池大小与实例数 | 连接数与实例数、连接池最大连接数、消费者并发数共同决定 |
3.4.2 通道数的约束来源
- 通道是连接上的逻辑多路复用,不占用操作系统的文件描述符,但每个通道占用服务端内存与内部句柄。
- 单条连接的通道数上限由
channel_max配置,默认2047;AMQP握手时客户端与服务端协商取两者中的较小值。 - 通道数通常与应用的线程数、消费者数量、并发消费配置相关:线程池或消费者并发配置扩大后,通道数同步扩大。
3.4.3 连接暴涨的排查
# 连接总数与按用户、vhost、来源地址的分布
rabbitmqctl list_connections user vhost peer_host state

# 按用户统计连接数
rabbitmqctl list_connections user | sort | uniq -c | sort -rn

# 通道数异常的连接(通道数与连接数应保持稳定比例)
rabbitmqctl list_connections name user channels

# 查看监听端口与当前连接相关的节点信息
rabbitmqctl status
排查顺序与判读:
- 先看连接总数与增长趋势:突增通常发生在发布、扩缩容、故障恢复或容器重建之后。
- 按来源地址与用户收敛范围,定位到具体应用与实例。
- 区分连接数与通道数的增长:连接数增长指向客户端行为(未复用连接、连接泄漏、重连风暴);通道数增长指向应用内部的线程数或消费者并发配置。
- 常见原因:每个请求新建Connection;连接池上限与实例数不匹配;容器重建后旧连接未及时释放;故障重连无退避造成重连风暴;异常未捕获导致连接未归还连接池。
- 处置:先推动客户端修复(复用连接、设置连接池与重连退避),服务端上限只作为兜底;服务端上限生效后新客户端会被拒绝接入。
3.4.4 心跳与超时
# /etc/rabbitmq/rabbitmq.conf
# 服务端默认心跳间隔(秒),握手时与客户端取值协商,取较小值
heartbeat = 60
# 握手超时(毫秒)
handshake_timeout = 10000
# 单节点最大连接数与单连接最大通道数
connection_max = 10000
channel_max = 2047
- 心跳的作用是检测半开连接:连接在心跳间隔内没有其他流量时,双方互发心跳帧;对端在一定时间内无响应即判定连接失效。心跳间隔取小时检测更快,但网络抖动会造成误判断连与重连风暴。
- 心跳间隔必须小于链路上防火墙、负载均衡与NAT的空闲超时。中间设备的空闲超时通常为数分钟,若心跳间隔大于该值,空闲连接会被中间设备单向断开,表现为消费者无故掉线而服务端连接仍然存在。
- 半开连接的发现延迟约为2个心跳周期,间隔越大,故障后消息重投与堆积告警的延迟越长。
- 握手超时用于限制连接建立与认证阶段的等待时间;认证依赖外部后端时,该值需要覆盖后端的正常响应时间。
高危:下调 connection_max 或 channel_max 会立即拒绝超出上限的新连接(含协商阶段失败),业务实例在扩容或重启时将无法接入;在vhost上设置max-connections会限制该vhost下的全部客户端,可能同时影响多个业务。执行前核对当前连接数与上限的余量,先通过客户端修复降低连接数,并在业务低峰变更。回滚方式:恢复原上限值即可,已建立的连接不受影响、无需重连;因上限被拒绝的客户端需在恢复后重新接入。
连接暴增的通用处置顺序与配额设计见 消息中间件运维与治理 第3.7节与第3.8节。
3.5 监控与告警指标
目标:掌握RabbitMQ侧需要采集的指标、堆积分级告警的判据,以及RabbitMQ指标与主机侧监控的分工。
3.5.1 启用rabbitmq_prometheus插件
# 启用Prometheus指标插件
rabbitmq-plugins enable rabbitmq_prometheus

# 验证指标端点(默认端口15692)
curl -s http://localhost:15692/metrics | head
- 插件默认监听15692端口,以Prometheus文本格式暴露指标,与管理插件的15672(页面与HTTP API)互不影响,两者可同时启用。
- 指标名以
rabbitmq_为前缀,多带queue、vhost、node等标签;队列数量多时标签基数会显著增加采集与存储开销,需要对不需要的队列做采集过滤或聚合。 - 部分指标名随插件版本略有差异,接入告警规则前以
/metrics的实际输出为准。
3.5.2 关键指标清单
| 类别 | 指标(示例名) | 含义与判读 |
|---|---|---|
| 队列深度 | rabbitmq_queue_messages | 队列中消息总数,需结合增长斜率判断是瞬时堆积还是持续堆积 |
| 就绪消息 | rabbitmq_queue_messages_ready | 等待投递的消息数,持续上升说明生产速率大于消费速率 |
| 未确认消息 | rabbitmq_queue_messages_unacknowledged | 已投递未确认的消息数,持续贴近prefetch上限说明消费端处理慢或被阻塞 |
| 发布速率 | rabbitmq_queue_messages_published_total | 单位时间入队消息数,用rate()换算 |
| 投递速率 | rabbitmq_queue_messages_delivered_total | 单位时间投递给消费者的消息数,下降说明消费侧受限 |
| 确认速率 | rabbitmq_queue_messages_acknowledged_total | 单位时间被确认的消息数,与发布速率共同决定堆积趋势 |
| 重投速率 | rabbitmq_queue_messages_redelivered_total | 消息被重新投递的次数,反映消费失败率 |
| 连接数 | rabbitmq_connections | 当前连接数,突增指向连接未复用、泄漏或重连风暴 |
| 连接累计 | rabbitmq_connections_opened_total、rabbitmq_connections_closed_total | 用于区分存量连接与短连接反复创建 |
| 通道数 | rabbitmq_channels | 当前通道数,增长指向应用线程数或消费者并发配置异常 |
| 消费者数 | rabbitmq_queue_consumers | 队列上的消费者数量,为0而堆积不为0说明消费者全部掉线 |
| 内存水位 | rabbitmq_process_resident_memory_bytes、rabbitmq_resident_memory_limit_bytes | 使用量与水位上限,两者接近即触发阻塞 |
| 磁盘水位 | rabbitmq_disk_space_available_bytes、rabbitmq_disk_space_available_limit_bytes | 剩余空间与下限,两者接近即触发阻塞 |
| Erlang进程数 | rabbitmq_erlang_processes_used | 与连接、通道、队列数量正相关,持续单调上升说明对象泄漏 |
| GC与调度 | rabbitmq_erlang_gc_runs_total、rabbitmq_erlang_gc_reclaimed_bytes_total、rabbitmq_erlang_scheduler_run_queue | GC次数与回收量突增通常伴随内存压力与延迟上升;调度器运行队列持续偏高说明CPU成为瓶颈 |
3.5.3 堆积分级告警建议
| 场景 | 判定条件 | 级别 | 处置 |
|---|---|---|---|
| 突发流量型 | 堆积快速上升但确认速率同步上升,估算清空时间小于业务容忍延迟 | info | 观察,确认消费者未受影响 |
| 消费能力不足 | 堆积持续增长,确认速率低于发布速率 | warning | 评估扩容消费者或优化消费逻辑 |
| 消费停滞 | 确认速率接近0且堆积大于0,或未确认消息数长时间贴近prefetch上限 | critical | 按故障处置流程介入 |
| 内存水位逼近 | 内存使用量接近水位上限,或日志出现内存告警 | critical | 定位内存占用来源,必要时扩容或调参(见3.3) |
| 磁盘水位逼近 | 磁盘剩余量接近水位下限,或按增长速率估算不足数天 | critical | 清理或扩容,避免写入被拒绝 |
| 死信增长 | 死信增量非零 | warning | 按死信处理流程分类处置 |
| 连接数异常 | 连接数超过基线1.5倍且持续 | warning | 按3.4.3排查客户端行为 |
- 阈值必须在采集一轮基线后按实际情况调整,不使用固定经验值;滞后的判据应换算为业务延迟后再与SLA绑定。
- 告警分级、阈值取值与通知路由的设计方法见 linux: 监控与告警 的告警级别与通知路由部分。
- 消息中间件侧指标的含义与分级策略见 消息中间件运维与治理 第2.2节与第3.2节。
3.5.4 与主机侧监控的分工
| 监控侧 | 负责的范围 | 对应手段 |
|---|---|---|
| 主机侧 | 节点是否存在、CPU使用率、可用内存、磁盘剩余与inode、磁盘I/O延迟、文件描述符、时间同步、进程与端口存活 | 主机指标采集,指标清单与判读见 linux: 监控与告警 第3.1节 |
| RabbitMQ侧 | 队列深度与堆积、未确认数、发布/投递/确认速率、消费者数量、连接与通道数、内存与磁盘水位、Erlang进程与GC、队列副本与leader分布 | rabbitmq_prometheus插件暴露的指标 |
两者的配合要点:
- 主机侧告警是RabbitMQ告警的前提:节点失联或抓取失败时,该节点上的队列与连接指标会同时缺失,应先用节点级告警判断。
- 主机侧磁盘与内存水位告警应早于RabbitMQ自身的水位阻塞触发,为清理与扩容留出处置时间;两者使用不同的阈值口径(主机侧按整体使用率,RabbitMQ侧按剩余量与下限的比较)。
- 使用告警抑制减少衍生告警:节点整体不可达时抑制该节点上的全部RabbitMQ指标告警;计划内的副本迁移与分区调整期间设置静默,窗口结束后确认告警恢复。
3.6 元数据备份与恢复
目标:掌握RabbitMQ元数据的导出与导入方式、升级前的备份步骤、集群重建流程,以及恢复后的一致性核对项。
3.6.1 definitions导出与导入
# 导出全部元数据(vhost、用户、权限、策略、参数、交换机、队列、绑定)
rabbitmqctl export_definitions /backup/rabbitmq-definitions-$(date +%F).json

# 只导出指定vhost
rabbitmqctl export_definitions /backup/defs-order.json --vhost /order

# 导入元数据
rabbitmqctl import_definitions /backup/rabbitmq-definitions-2026-09-21.json
- 导出文件为JSON,包含vhost、用户、用户标签与vhost权限(含密码哈希)、策略、参数、交换机、队列(含队列类型与参数)、绑定关系。
- 导出文件不包含消息数据与消费位点:消息数据的可用性依靠副本、消费端落库或归档,处理原则见 消息中间件运维与治理 第3.4节。
- 早期版本没有 export_definitions 命令时,可用管理界面的 Overview → Export definitions,或 rabbitmqadmin 的导出功能。
3.6.2 备份内容清单
| 对象 | 载体 | 恢复作用 |
|---|---|---|
| 交换机、队列、绑定 | definitions导出文件 | 重建拓扑与队列属性(含队列类型) |
| vhost | definitions导出文件 | 重建命名空间 |
| 用户、tags、vhost权限 | definitions导出文件 | 重建账号与授权 |
| 策略与参数 | definitions导出文件 | 恢复长度上限、TTL、死信与副本等运行配置 |
| 节点配置文件 | rabbitmq.conf、advanced.config 的副本 | 恢复水位、心跳、连接上限等节点级配置 |
| 插件启用清单 | rabbitmq-plugins list -E 的输出 | 恢复管理、Prometheus、延迟消息等插件 |
| Erlang Cookie | 单独保存的 .erlang.cookie | 重建集群时的节点认证 |
3.6.3 升级前的备份步骤
- 记录版本与插件清单:
rabbitmqctl version、rabbitmq-plugins list -E; - 导出definitions到独立存储,不与消息数据盘共用同一块磁盘;
- 备份 /etc/rabbitmq 下的 rabbitmq.conf、advanced.config 与 .erlang.cookie;
- 记录易被忽略的集群级设置:vhost默认队列类型、vhost资源限制、用户标签;
- 打开导出文件核对内容:vhost、用户、队列数量与预期一致,队列的type与arguments正确;
- 记录基线数量,作为恢复后比对的依据:
# 队列数量与各队列的消息数、消费者数基线
rabbitmqctl list_queues name type messages consumers | tee /backup/queues-baseline-$(date +%F).txt
3.6.4 集群重建流程
- 按3.1安装相同版本的Erlang与RabbitMQ;
- 恢复节点配置文件(rabbitmq.conf、advanced.config)与Erlang Cookie,保证节点级参数与集群认证一致;
- 按3.2.3组建集群,确认
rabbitmqctl cluster_status中节点齐全; - 启用原插件清单中的插件(先启用 rabbitmq_management 与 rabbitmq_prometheus);
- 导入definitions;
- 按3.6.5逐项核对,并确认仲裁队列的副本成员已按集群节点重新分布;
- 核对完成后开放业务接入,观察队列深度、死信与延迟指标。
高危:import_definitions 会按导出内容创建或覆盖对象,导入到已有数据的集群上会覆盖同名vhost、用户、权限、策略与参数配置;同名队列的arguments不一致时会导致导入报错或队列被删除重建。执行前确认目标为空集群或已明确可覆盖,并先对当前状态执行一次导出作为回滚点。回滚方式:重新导入导入前导出definitions即可恢复拓扑与配置;被删除重建的队列中已有消息无法恢复,只能依靠副本、归档或上游重发。集群重建本身会清空节点数据,属于不可回滚操作,必须在确认存在可用备份与业务侧数据副本后再执行。
3.6.5 恢复后的一致性核对
| 核对项 | 命令 | 判据 |
|---|---|---|
| 对象数量 | rabbitmqctl list_vhosts、rabbitmqctl list_queues、rabbitmqctl list_exchanges | 与导出时的数量一致 |
| 队列属性 | rabbitmqctl list_queues name type durable arguments | 队列类型、持久化标识、长度上限与死信参数与备份一致 |
| 用户与权限 | rabbitmqctl list_users、rabbitmqctl list_permissions -p /order | tags与conf/write/read与备份一致,业务账号无多余tag |
| 策略与参数 | rabbitmqctl list_policies、rabbitmqctl list_parameters | 需要的策略已恢复,且无镜像队列残留策略 |
| 插件 | rabbitmq-plugins list -E | 与备份记录一致 |
| 副本分布 | rabbitmqctl list_queues name type leader members online | 副本成员覆盖多个节点,leader分布正常 |
| 客户端接入 | 以业务账号连接并声明或消费一次 | 不因权限或队列属性不一致报错 |
账号与权限的建模方式见 RabbitMQ 用户角色和权限说明。
3.7 网络分区处理
目标:理解网络分区的成因与判定依据,掌握分区处理策略的取舍、恢复步骤与预防手段。
3.7.1 分区的成因与判定
- 成因:集群节点之间的网络中断,包括交换机故障、网段隔离、防火墙规则变更、跨机房链路抖动、以及节点负载过高导致心跳超时。
- 判定依据:节点之间通过net tick机制互相检测,默认每60秒无消息往来即判定对端不可达;日志出现节点不可达与分区相关的记录,
rabbitmqctl cluster_status输出中出现 partitions 段,运行节点列表中缺少对端节点。 - 分区的后果取决于队列类型:仲裁队列基于多数派,少数派一侧无法形成多数派,其上的队列不可读写,这本身抑制了双写;经典队列的副本能力已移除,分区两侧的节点各自持有部分队列,恢复后需要人工处理。
# 查看分区状态与各节点可见的运行节点
rabbitmqctl cluster_status

# 检查节点间的端口连通性(25672为集群通信端口)
rabbitmq-diagnostics check_port_connectivity
3.7.2 分区处理策略的取舍
配置项为 cluster_partition_handling:
| 取值 | 行为 | 取舍 |
|---|---|---|
| ignore | 不自动处理,分区两侧各自继续运行,网络恢复后需人工介入 | 默认值;可用性优先,但可能出现两侧都能写入的分歧,恢复时依赖人工判断 |
| pause_minority | 少数派一侧的节点自动暂停服务,多数派一侧继续运行 | 一致性优先,避免双写;要求节点数为奇数,且集群规模不宜过大,否则一次分区可能导致两侧同时暂停;不适用于跨机房部署 |
| autoheal | 网络恢复后以数据量较多的一侧为准,重启另一侧节点并清除其数据 | 恢复自动化;代价是少数派一侧在分区期间的数据被丢弃,节点重启带来额外不可用 |
| pause_if_all_down | 指定必须可达的节点集合,集合内节点全部不可达时暂停服务 | 用于跨机房或需要显式仲裁成员的场景 |
# /etc/rabbitmq/rabbitmq.conf
# 分区处理策略:同机房奇数节点集群推荐 pause_minority
cluster_partition_handling = pause_minority
选择依据:更看重一致性(宁可少部分节点不可用也不出现双写)时选择 pause_minority;需要网络恢复后自动收敛且可接受丢弃少数派数据时选择 autoheal。无论选择哪种策略,分区期间都不得手工强制启动少数派一侧来恢复服务。
3.7.3 分区后的恢复步骤
- 确认分区范围:通过
rabbitmqctl cluster_status确认哪些节点互相可见,记录 partitions 段内容与时间点。 - 保护数据:停止两侧的生产者写入,保全两侧节点的数据目录与日志,禁止在根因不明时格式化任何一侧。
- 判定保留侧:以数据更完整或与外部记录一致的一侧为准,依据是队列消息数、消费位点与业务表核对结果。
- 恢复网络:确认节点之间25672端口与Erlang分发端口互通,核对防火墙与安全组规则。
- 在被放弃的一侧重置并重新加入集群:
# 在被放弃的节点上执行:停止应用、重置、重新加入、启动应用
rabbitmqctl stop_app
rabbitmqctl reset
rabbitmqctl join_cluster rabbit@node1
rabbitmqctl start_app
高危:rabbitmqctl reset 会清空该节点的全部数据与队列副本,在该节点上确认但未被多数派复制的消息将永久丢失。执行前必须完成两侧数据核对(队列消息数、消费位点、业务表),确认被放弃侧的数据可由保留侧或上游重建,并保存两侧的数据目录与日志切片。回滚方式:重置不可回滚;重置前应对数据目录做完整快照或磁盘级备份,保留至新集群稳定运行并完成对账后再清理。
- 数据核对:恢复后核对队列消息数与业务表、确认副本成员数量已回到预期、leader分布正常、死信增量为0。
- 关闭分区期间创建的告警静默,核对告警恢复正常,并把本次分区的时间点、影响范围与处置记录归档。
3.7.4 预防手段
- 节点数量取奇数并使用仲裁队列:多数派规则使少数派无法形成可写入的副本集合。
- 集群节点部署在同一低延迟网络内,避免跨机房组建单个集群;跨机房需求使用Federation、Shovel或双集群方案。
- 明确配置
cluster_partition_handling并纳入集群验收项,不使用默认的ignore而不做决策。 - 监控节点可达性与net tick相关告警:
rabbitmq-diagnostics cluster_status与节点存活探测纳入巡检。 - 分区期间禁止手工强制启动少数派节点,禁止在两侧同时开放写入。
- 分区的通用模型、quorum判据与切换演练要求见 linux: 高可用与集群。
3.8 策略与参数的区别及vhost多租户规划
目标:区分策略(policy)与参数(parameter)两类配置的作用范围与生效方式,并给出vhost多租户的划分与权限最小化做法。
3.8.1 策略与参数的区别
| 维度 | 策略(policy) | 参数(parameter) |
|---|---|---|
| 作用对象 | 按名称正则匹配的一组队列或交换机 | 节点级或vhost级的具名设置 |
| 匹配方式 | pattern正则匹配资源名,可设置priority处理多条策略的冲突 | 按固定名称定义,不按资源正则匹配 |
| 生效方式 | 动态、立即生效,可随时新增、修改、清除 | 设置后由对应组件读取使用 |
| 典型用途 | 队列长度上限、TTL、死信、溢出行为、投递次数上限等运行参数 | Federation上游定义、Shovel定义等组件级配置 |
| 常用命令 | set_policy、list_policies、clear_policy | set_parameter、list_parameters、clear_parameter |
| 备份方式 | 包含在definitions导出文件中 | 包含在definitions导出文件中 |
# 策略:为 /order 中 order_ 前缀的队列设置长度上限
rabbitmqctl set_policy -p /order order-limit "^order_" '{"max-length":100000}' --apply-to queues

# 查看策略与其生效范围
rabbitmqctl list_policies -p /order

# 参数:为 /order 定义一个Federation上游
rabbitmqctl set_parameter -p /order federation-upstream upstream-1 '{"uri":"amqp://node1","ack-mode":"on-confirm"}'

# 查看参数
rabbitmqctl list_parameters
补充:
- 队列声明时的参数(x-arguments)在声明时固定,修改需要重新声明;属性不一致时重新声明会报错。策略是附加在既有资源上的动态配置,二者可以作用于同一队列,实际生效值以
rabbitmqctl list_queues name arguments effective_policy_definition与rabbitmqctl list_policies的输出为准。 - 镜像队列时代的
ha-mode属于策略键,随镜像队列功能一起被移除;升级后应确认无此类残留策略(见3.2.6)。
3.8.2 vhost多租户规划
划分原则:
- 选择单一主维度:按环境划分(dev、test、prod)或按业务线划分,避免同时按两个维度划分导致vhost数量膨胀。
- 一个业务线在同一环境共用一个vhost;共用vhost的前提是资源命名有统一前缀约定,且共享同一套权限与配额。
- vhost之间交换机、队列、绑定与用户权限互相独立;同一vhost内的资源互相可见,因此不同团队或数据敏感度差异大的业务不宜共用一个vhost。
- vhost数量需要与账号、配额、监控分组一一对应,划分过细会放大权限管理与监控配置的工作量。
权限最小化:
# 创建vhost
rabbitmqctl add_vhost /order

# 业务账号:只能操作 order_ 前缀的资源,queue由运维预建,因此conf权限为空
rabbitmqctl set_permissions -p /order order_app "^order_" "^order_" "^order_"

# 监控账号:只读,可登录管理界面查看
rabbitmqctl set_user_tags order_monitor monitoring
rabbitmqctl set_permissions -p /order order_monitor "" "" "^order_"

# vhost资源限制:限制该vhost的连接数与队列数
rabbitmqctl set_vhost_limits -p /order '{"max-connections":1000,"max-queues":500}'
- 按用途分账号:生产账号、消费账号、管理账号、监控账号;业务账号不授予管理tag,只依赖vhost权限收发消息。
- 权限范围按资源名前缀收敛,避免使用全匹配的通配符授权。
- vhost资源限制需要留有余量:限制过低会导致业务正常峰值被拒绝,过高则失去隔离意义。
- vhost与账号的变更纳入登记与审批流程,定期核对清单与实际使用者。
- 用户标签与vhost权限的完整说明见 RabbitMQ 用户角色和权限说明;多租户与安全的整体要求见 消息中间件运维与治理 第3.8节。
3.9 运维命令
# 1. 服务管理
sudo systemctl start rabbitmq-server # 启动
sudo systemctl stop rabbitmq-server # 停止
sudo systemctl restart rabbitmq-server # 重启
sudo systemctl status rabbitmq-server # 查看状态

# 2. 节点管理
rabbitmqctl cluster_status # 查看集群状态
rabbitmqctl join_cluster rabbit@node1 # 加入集群
rabbitmqctl leave_cluster # 退出集群
rabbitmqctl reset # 重置节点(退出集群后需执行,清空数据)

# 3. 用户管理
rabbitmqctl add_user 用户名 密码 # 创建用户
rabbitmqctl delete_user 用户名 # 删除用户
rabbitmqctl set_user_tags 用户名 administrator # 设置管理员权限
rabbitmqctl list_users # 查看所有用户

# 4. 队列/交换机管理
rabbitmqctl list_queues # 查看所有队列
rabbitmqctl delete_queue 队列名 # 删除队列
rabbitmqctl list_exchanges # 查看所有交换机
rabbitmqctl delete_exchange 交换机名 # 删除交换机

# 5. 消息管理
rabbitmqctl purge_queue 队列名 # 清空队列中的所有消息
rabbitmqctl list_queues name messages_ready messages_unacknowledged # 查看队列消息数(就绪/未确认)

# 6. 插件管理
rabbitmq-plugins enable 插件名 # 启用插件
rabbitmq-plugins disable 插件名 # 禁用插件
rabbitmq-plugins list # 查看所有插件
补充:命令未指定vhost时作用于默认vhost;对指定vhost的资源操作使用 -p <vhost> 参数。
高危:delete_queue、delete_exchange、purge_queue 均为不可撤销操作。delete_queue 会同时删除队列中的全部消息、绑定关系与消费位点;purge_queue 会删除队列中全部就绪消息,二者删除后消息与位点均无法恢复。执行前先导出definitions作为拓扑重建依据(见3.6),确认队列的消费者已停止、就绪与未确认消息数均为0,或消息已完成归档,并核对操作对象名称精确匹配、不使用模糊匹配。回滚方式:拓扑可按definitions备份重建,消息数据只能由副本、归档或上游重发补齐;无法重建时不得执行。
第四部分:RabbitMQ开发实操(Java Spring Boot集成)
目标:掌握Spring Boot集成RabbitMQ的完整流程,包括生产者发送消息、消费者接收消息,以及核心机制(持久化、确认、死信、延迟)的代码实现,贴合生产环境开发规范。
前置准备:创建Spring Boot项目(2.7+版本),引入RabbitMQ依赖,配置RabbitMQ连接信息。
4.1 步骤1:引入依赖(pom.xml)
<!-- RabbitMQ核心依赖 -->
<dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-amqp</artifactId>
</dependency>

<!-- 测试依赖(可选) -->
<dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-test</artifactId>
    <scope>test</scope>
</dependency>
4.2 步骤2:配置RabbitMQ(application.yml)
spring:
  rabbitmq:
    # RabbitMQ连接信息(集群部署时,用逗号分隔多个节点IP)
    addresses: 192.168.1.101:5672,192.168.1.102:5672,192.168.1.103:5672
    username: admin
    password: 123456
    virtual-host: / # 虚拟主机,默认“/”
    port: 5672 # 客户端通信端口
    # 生产者确认配置(异步确认,推荐)
    publisher-confirm-type: correlated
    # 生产者返回机制(消息未路由到队列时,返回给生产者)
    publisher-returns: true
    template:
      mandatory: true # 开启强制返回,确保消息未路由时能被捕获
    # 消费者配置(手动确认,限流)
    listener:
      simple:
        acknowledge-mode: manual # 手动确认模式
        prefetch: 5 # 限流,每次预取5条消息
        concurrency: 2 # 消费者线程数(多线程处理)
        max-concurrency: 5 # 最大消费者线程数
4.3 步骤3:组件配置(交换机、队列、绑定)
推荐使用Java代码配置(而非手动在管理界面创建),确保配置可复用、可版本控制,以下示例配置“Direct交换机+正常队列+死信队列”,涵盖持久化、死信等核心特性。
import org.springframework.amqp.core.*;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;

@Configuration
public class RabbitMQConfig {

    // 1. 正常交换机(Direct类型,持久化)
    @Bean
    public DirectExchange normalExchange() {
        // 参数:交换机名称、是否持久化、是否自动删除、额外参数
        return new DirectExchange("normal_exchange", true, false);
    }

    // 2. 正常队列(持久化,绑定死信交换机)
    @Bean
    public Queue normalQueue() {
        // 队列参数:设置死信交换机和死信路由键
        return QueueBuilder.durable("normal_queue")
                .deadLetterExchange("dlx_exchange") // 死信交换机名称
                .deadLetterRoutingKey("dlx_routing_key") // 死信路由键
                .maxLength(1000) // 队列最大长度(限流)
                .build();
    }

    // 3. 正常队列与正常交换机绑定
    @Bean
    public Binding normalBinding(Queue normalQueue, DirectExchange normalExchange) {
        // 参数:队列、交换机、路由键
        return BindingBuilder.bind(normalQueue)
                .to(normalExchange)
                .with("normal_routing_key");
    }

    // 4. 死信交换机(Direct类型,持久化)
    @Bean
    public DirectExchange dlxExchange() {
        return new DirectExchange("dlx_exchange", true, false);
    }

    // 5. 死信队列(持久化)
    @Bean
    public Queue dlxQueue() {
        return QueueBuilder.durable("dlx_queue").build();
    }

    // 6. 死信队列与死信交换机绑定
    @Bean
    public Binding dlxBinding(Queue dlxQueue, DirectExchange dlxExchange) {
        return BindingBuilder.bind(dlxQueue)
                .to(dlxExchange)
                .with("dlx_routing_key");
    }

    // 7. 延迟交换机(插件方式,可选)
    @Bean
    public CustomExchange delayedExchange() {
        // 参数:交换机名称、类型(x-delayed-message)、是否持久化、是否自动删除、额外参数(底层路由类型)
        return new CustomExchange("delayed_exchange", "x-delayed-message", true, false,
                Map.of("x-delayed-type", "direct"));
    }

    // 8. 延迟队列(绑定到延迟交换机)
    @Bean
    public Queue delayedQueue() {
        return QueueBuilder.durable("delayed_queue").build();
    }

    // 9. 延迟队列与延迟交换机绑定
    @Bean
    public Binding delayedBinding(Queue delayedQueue, CustomExchange delayedExchange) {
        return BindingBuilder.bind(delayedQueue)
                .to(delayedExchange)
                .with("delayed_routing_key")
                .noargs();
    }
}
4.4 步骤4:生产者
生产者核心职责:构建消息、绑定交换机与路由键、发送消息,同时实现消息确认、消息回退、异常重试等生产级特性,保证消息投递可靠性。本次实现普通消息发送、延迟消息发送两大核心场景。
4.4.1 生产者工具类(封装消息发送方法)
import lombok.RequiredArgsConstructor;
import lombok.extern.slf4j.Slf4j;
import org.springframework.amqp.core.Message;
import org.springframework.amqp.core.MessageDeliveryMode;
import org.springframework.amqp.core.MessageProperties;
import org.springframework.amqp.rabbit.connection.CorrelationData;
import org.springframework.amqp.rabbit.core.RabbitTemplate;
import org.springframework.stereotype.Component;

import javax.annotation.PostConstruct;
import java.util.UUID;

@Slf4j
@Component
@RequiredArgsConstructor
public class RabbitMQProducer {

    private final RabbitTemplate rabbitTemplate;

    /**
     * 初始化消息确认、消息回退回调(全局生效)
     */
    @PostConstruct
    public void initCallback() {
        // 1. 生产者确认回调:消息抵达交换机触发(成功/失败)
        rabbitTemplate.setConfirmCallback((correlationData, ack, cause) -> {
            if (ack) {
                log.info("消息投递交换机成功,消息ID:{}", correlationData != null ? correlationData.getId() : null);
            } else {
                log.error("消息投递交换机失败,消息ID:{},失败原因:{}", correlationData != null ? correlationData.getId() : null, cause);
                // 此处可扩展:失败消息入库、定时重试
            }
        });

        // 2. 消息回退回调:消息抵达交换机但未匹配到队列触发
        rabbitTemplate.setReturnsCallback(returned -> {
            log.error("消息路由失败,消息内容:{},回复码:{},回复信息:{},交换机:{},路由键:{}",
                    new String(returned.getMessage().getBody()),
                    returned.getReplyCode(),
                    returned.getReplyText(),
                    returned.getExchange(),
                    returned.getRoutingKey());
            // 此处可扩展:路由失败消息兜底处理
        });
    }

    /**
     * 发送普通持久化消息
     * @param msgContent 消息内容
     */
    public void sendNormalMsg(String msgContent) {
        // 构建消息唯一ID,用于消息溯源确认
        CorrelationData correlationData = new CorrelationData(UUID.randomUUID().toString().replace("-", ""));

        // 构建消息属性:持久化消息,重启不丢失
        MessageProperties messageProperties = new MessageProperties();
        messageProperties.setDeliveryMode(MessageDeliveryMode.PERSISTENT);
        Message message = new Message(msgContent.getBytes(), messageProperties);

        // 发送消息:指定交换机、路由键、消息体、消息ID
        rabbitTemplate.convertAndSend("normal_exchange", "normal_routing_key", message, correlationData);
        log.info("普通消息发送成功,消息内容:{},消息ID:{}", msgContent, correlationData.getId());
    }

    /**
     * 发送延迟消息
     * @param msgContent 消息内容
     * @param delayTime 延迟时间(单位:毫秒)
     */
    public void sendDelayedMsg(String msgContent, long delayTime) {
        CorrelationData correlationData = new CorrelationData(UUID.randomUUID().toString().replace("-", ""));

        // 延迟消息核心:设置x-delay延迟参数
        rabbitTemplate.convertAndSend("delayed_exchange", "delayed_routing_key", msgContent, message -> {
            message.getMessageProperties().setDeliveryMode(MessageDeliveryMode.PERSISTENT);
            message.getMessageProperties().setHeader("x-delay", delayTime);
            return message;
        }, correlationData);

        log.info("延迟消息发送成功,延迟时间:{}ms,消息内容:{},消息ID:{}", delayTime, msgContent, correlationData.getId());
    }
}
4.4.2 生产者测试接口(快速调试)
import lombok.RequiredArgsConstructor;
import org.springframework.web.bind.annotation.GetMapping;
import org.springframework.web.bind.annotation.RequestMapping;
import org.springframework.web.bind.annotation.RequestParam;
import org.springframework.web.bind.annotation.RestController;

@RestController
@RequestMapping("/rabbit")
@RequiredArgsConstructor
public class RabbitMQController {

    private final RabbitMQProducer rabbitMQProducer;

    // 测试发送普通消息
    @GetMapping("/send/normal")
    public String sendNormalMsg(@RequestParam String content) {
        rabbitMQProducer.sendNormalMsg(content);
        return "普通消息发送完成";
    }

    // 测试发送延迟消息
    @GetMapping("/send/delayed")
    public String sendDelayedMsg(@RequestParam String content, @RequestParam long delay) {
        rabbitMQProducer.sendDelayedMsg(content, delay);
        return "延迟消息发送完成,延迟时长:" + delay + "ms";
    }
}
4.5 步骤5:消费者代码实现(手动确认+异常处理)
消费者采用手动ACK确认机制,保证消息消费可靠性,消费成功手动签收,消费失败拒绝签收并重回队列或进入死信队列,杜绝消息丢失、重复消费问题。
4.5.1 普通队列消费者
import com.rabbitmq.client.Channel;
import lombok.extern.slf4j.Slf4j;
import org.springframework.amqp.rabbit.annotation.RabbitListener;
import org.springframework.amqp.support.AmqpHeaders;
import org.springframework.messaging.handler.annotation.Header;
import org.springframework.stereotype.Component;

@Slf4j
@Component
public class NormalMsgConsumer {

    /**
     * 监听普通业务队列
     * @param msg 消息内容
     * @param channel 消息通道
     * @param deliveryTag 消息标签(用于ACK确认)
     * @throws Exception 消费异常
     */
    @RabbitListener(queues = "normal_queue")
    public void consumeNormalMsg(String msg, Channel channel, @Header(AmqpHeaders.DELIVERY_TAG) long deliveryTag) throws Exception {
        try {
            // 模拟业务消费逻辑
            log.info("普通队列接收消息:{}", msg);
            // 手动ACK确认:消费成功,签收消息,队列删除该消息
            channel.basicAck(deliveryTag, false);
            log.info("普通消息消费确认成功");
        } catch (Exception e) {
            log.error("普通消息消费异常,消息内容:{},异常信息:{}", msg, e.getMessage());
            // 消费失败,拒绝签收,不重回队列(进入死信队列)
            channel.basicNack(deliveryTag, false, false);
        }
    }
}
4.5.2 死信队列消费者(异常消息兜底处理)
import com.rabbitmq.client.Channel;
import lombok.extern.slf4j.Slf4j;
import org.springframework.amqp.rabbit.annotation.RabbitListener;
import org.springframework.amqp.support.AmqpHeaders;
import org.springframework.messaging.handler.annotation.Header;
import org.springframework.stereotype.Component;

@Slf4j
@Component
public class DlxMsgConsumer {

    /**
     * 监听死信队列,处理消费失败、过期、超长的异常消息
     */
    @RabbitListener(queues = "dlx_queue")
    public void consumeDlxMsg(String msg, Channel channel, @Header(AmqpHeaders.DELIVERY_TAG) long deliveryTag) throws Exception {
        try {
            log.warn("死信队列接收异常消息:{},开始兜底处理", msg);
            // 此处可扩展:消息告警、人工重试、数据入库归档
            channel.basicAck(deliveryTag, false);
            log.info("死信消息处理完成");
        } catch (Exception e) {
            log.error("死信消息处理失败:{}", e.getMessage());
            channel.basicAck(deliveryTag, false);
        }
    }
}
4.5.3 延迟队列消费者
import com.rabbitmq.client.Channel;
import lombok.extern.slf4j.Slf4j;
import org.springframework.amqp.rabbit.annotation.RabbitListener;
import org.springframework.amqp.support.AmqpHeaders;
import org.springframework.messaging.handler.annotation.Header;
import org.springframework.stereotype.Component;

@Slf4j
@Component
public class DelayedMsgConsumer {

    /**
     * 监听延迟队列,延迟时间到期后消费消息
     */
    @RabbitListener(queues = "delayed_queue")
    public void consumeDelayedMsg(String msg, Channel channel, @Header(AmqpHeaders.DELIVERY_TAG) long deliveryTag) throws Exception {
        try {
            log.info("延迟消息到期消费,消息内容:{}", msg);
            // 执行延迟业务逻辑(如订单超时取消、定时通知等)
            channel.basicAck(deliveryTag, false);
        } catch (Exception e) {
            log.error("延迟消息消费失败:{}", e.getMessage());
            channel.basicNack(deliveryTag, false, false);
        }
    }
}
4.6 机制总结(生产重点)
-
消息持久化:交换机、队列持久化 + 消息持久化,服务重启消息不丢失;
-
生产者可靠性:开启confirm确认、returns回退,精准监控消息投递状态;
-
消费者可靠性:手动ACK机制,避免消息重复消费、丢失;
-
死信兜底机制:消费失败、消息过期、队列溢出的消息自动进入死信队列,保证消息不丢失;
-
延迟消息:基于RabbitMQ延迟插件实现,适配订单超时、定时任务场景。
4.7 项目启动验证步骤
-
启动Spring Boot项目,查看日志无报错,RabbitMQ连接成功;
-
访问接口
http://localhost:端口/rabbit/send/normal?content=测试普通消息,查看生产者发送、消费者消费日志; -
访问接口
http://localhost:端口/rabbit/send/delayed?content=测试延迟消息&delay=5000,5秒后自动消费消息; -
登录RabbitMQ管理界面,查看交换机、队列创建状态及消息流转记录。